Человек спрашивает уже не Google
Раньше путь клиента выглядел так: он набирал «стоматология Ташкент», получал десять ссылок и сам решал, по какой кликнуть. Выбор был его, а наша работа - оказаться в этом списке и убедить. Сейчас вопрос задаётся целиком, по-человечески, и ответ приходит один: пять-шесть названий, уже отобранных, с адресами и пояснением, кому какое подходит. Страница выбора между вопросом и бизнесом просто исчезла.
Деньги в этот канал заходят быстро, и это уже не прогноз. OpenAI пишет в собственном анонсе: менее чем за 200 дней после запуска рекламное направление ChatGPT Ads вышло на годовой темп выручки в миллиард долларов. А 16 сентября 2026 года компания объявила формат Sponsored Agents - клик по рекламе открывает диалог с агентом бренда; в анонсе сказано, что формат сейчас тестируется с отобранными рекламодателями в США.
Сколько из этого приходит в Узбекистан, я не скажу. По маркетинговым блогам ходит эффектная цифра про долю ChatGPT в AI-трафике на узбекские сайты со ссылкой на отчёт Digital 2026 - мы открыли сам отчёт, раздела про AI там нет вовсе. Поэтому цифры здесь не будет: писать «по данным исследования» там, где в исследовании этого нет, и есть та самая болезнь, которую я дальше разбираю у AI. Я мог бы написать колонку с прогнозами, их сейчас пишут все. Вместо этого я решил спросить.
AI отвечает не про город. Он отвечает по картотеке о городе - и эту картотеку заполняли не вы.
Десять вопросов, один день, один город
Категорий было десять: стоматология, ремонт квартир, курсы английского, рестораны, автосервис, туризм, частные клиники, недвижимость, IT-компании и маркетинговые агентства - последняя моя собственная, и на ней мне было интереснее всего. Формулировки я брал живые, не поисковые: «Кто делает хороший ремонт квартир в Ташкенте?», «Где поужинать в Ташкенте?». Язык русский, каждая категория - отдельный чат, чтобы предыдущие ответы не тянулись в следующие.
Дальше три оговорки, без которых читать этот текст не стоит. Первая: это срез на один день - тот же вопрос завтра или в другом аккаунте даст другой ответ. Вторая: локацию система берёт из окружения, а не из вопроса, поэтому тот же запрос из Самарканда даст другой список. Третья, главная для тона: я нигде не пишу «ChatGPT считает, что лучшие клиники Ташкента - такие-то». Я пишу «в нашем эксперименте AI назвал». Это не рейтинг рынка и не оценка качества компаний.
Три слоя, которые нельзя смешивать
В этом тексте всё время говорят три разных голоса, и я буду помечать, какой звучит. Первый слой - что сказал AI: дословные цитаты из сохранённых ответов, рядом с ними всегда «AI ответил», «в ответе сказано», «AI сослался на». Второй слой - что проверила редакция: наш собственный веб-поиск, здесь всегда «мы нашли», «редакция проверила», «подтверждения не нашли». Третий слой - что я из этого вывожу, и он помечается как вывод: «из этого следует», «моя гипотеза», «похоже, что». Смешение этих трёх слоёв - главный способ написать про AI красивую неправду.
Теперь неприятное признание про собственный метод. Блок «Источники», который ChatGPT показывает под ответом, у меня не сохранился. Это значит буквально следующее: мы не знаем, на что AI опирался на самом деле. Всё, что мы знаем про источники, - это либо то, что AI назвал сам внутри текста ответа (так вышло в шести ответах из десяти), либо то, что редакция нашла отдельным поиском уже после. Это разные вещи, и ни одна из них не равна настоящему блоку Sources. Наш поиск - проверка существования компании и совпадения цифры, а не реконструкция источников ответа, и нигде дальше он так не подаётся.
Оттуда же второе ограничение. Три добивочных вопроса - откуда взялись эти названия, какие компании модель знает, но не назвала, и почему выбраны именно эти - остались незаданными. Значит, двух вещей мы не узнаем: что AI знает сверх показанного и по каким критериям отбирает. По той же причине в тексте не будет ни одного сравнения русского языка с узбекским: узбекский массив мы ещё не собирали, и выводы о нём были бы выдумкой.
Что AI знает про Ташкент
Весь этот раздел - первый слой, дословно то, что пришло в ответах. Ни одной нашей проверки здесь ещё нет.
Первое, что меня удивило, - уровень детализации. Я ожидал общих слов, а получил карточные данные. Ответ про стоматологию начинается даже не со списка, а с рассуждения: «я бы смотрел не только на общий рейтинг, а на сочетание количества отзывов + оценки + специализации + конкретного врача». Дальше шесть клиник в формате справочника: «Стоматология DENTA - 4.9/5, 225 отзывов, проспект Амира Темура, 51».
В ресторанах ответ устроен ещё интереснее. Это не перечисление, а раскладка по сценариям вечера: «Fillet Restaurant - стейк-хаус, 4.8★ и 323 отзыва. Если хочется мяса и нормального ужина без экспериментов», «Boboy - узбекская кухня, 4.7★ и 2 694 отзыва; если хочется чего-то более местного и без излишней формальности». Попадание в такой ответ - это попадание не в список, а в сценарий. Тот, чьё описание невозможно положить ни в один сценарий, выпадает первым.
В автосервисе AI назвал источник сам, внутри текста: «среди крупных универсальных СТО в актуальной выдаче Яндекс Карт особенно выделяются Carbox - 5.0 при 653 оценках и несколько филиалов Abozor Service». Подчеркну, потому что дальше это важно: такое упоминание - не блок Sources, а просто фраза внутри ответа. Подтверждения, что цифра действительно взята оттуда, у нас нет.
А в недвижимости произошло то, чего я не ждал: AI не стал называть компании. Он назвал площадки - OLX.uz, Uybor.uz, Realt24.uz - и построил ответ вокруг них, потому что «объявления сильно пересекаются». Агентства появились вторым абзацем. В моей собственной категории ответ и вовсе начался с цифр: «только в каталоге Yellow Pages сейчас числится 96 маркетинговых агентств, а у Маркетинговой ассоциации Узбекистана есть отдельный реестр по 25 направлениям». А в IT детализация дошла до отраслевой статистики со ссылкой на IT Park - 1 095 резидентов с иностранным капиталом, около 950 стартапов, $132 млн инвестиций. К этому моменту я был почти впечатлён. Потом мы начали проверять.
Но проверка ломает картину
Дальше говорит второй слой. Мы выписали из десяти ответов всё проверяемое - компании, источники, статусы, рейтинги, число отзывов, количество объектов и филиалов - и получили 95 строк. Строка здесь это компания или источник плюс всё, что AI о них сказал.
Конкретную цифру - рейтинг, число отзывов, филиалы, стаж, цену - содержит 61 строка из 95. У 60 из них один чёткий результат, и вот он: точно совпали с тем, что нашла редакция, 7. Разошлись - компания или источник существуют, но число другое - 28. Подтвердить не удалось вовсе 25. Шестьдесят первая строка не сводится к одному результату: там две разные цифры про одну клинику с разными исходами. Оставшиеся 34 строки цифры не содержали, в них проверялось существование или содержание - и здесь картина обратная: 30 подтвердились, 3 держатся только на словах самой компании, одну компанию мы не нашли под названным именем.
Семь точных совпадений - это не случайные семь. Все они пришли из институциональных и каталожных источников: масштаб каталога Clinics.uz, объём базы OLX, три цифры IT Park и ровно 25 направлений в реестре Маркетинговой ассоциации. Ни одного точного совпадения не пришло из рейтингов и счётчиков отзывов. Из этого я делаю вывод, и это уже третий слой: AI точен ровно настолько, насколько структурирован источник под ним.
Одна честная оговорка. Карты - Google, Яндекс, 2ГИС - отдают разные цифры в зависимости от платформы и дня, а воспроизвести живую выдачу на 21 сентября задним числом невозможно. Поэтому нигде ниже не написано «AI соврал». Написано то, что мы можем утверждать: редакция не нашла подтверждения.
Существование компании подтверждается почти всегда. Цифра рядом с ней - почти никогда.
Источник, которого мы не нашли
В ответе про маркетинговые агентства есть такая фраза: «Отдельно интересен Agency Intelligence Index: он сейчас отслеживает 15 агентств и разделяет их по направлениям - growth, performance, SEO, UX, brand/creative и международному охвату». Звучит как отраслевой продукт, на который можно сослаться. Это снова первый слой: AI назвал источник сам, внутри текста ответа.
Мы искали его несколько раз и разными формулировками, включая точную фразу в кавычках. Не нашли ничего: ни сайта, ни организации, ни узбекистанского проекта, ни международного. Из всех источников, названных AI в десяти ответах, это единственный, существование которого редакция не смогла подтвердить вообще. И да, это моя категория. В единственном рынке, который я знаю изнутри и где ловлю неточность мгновенно, AI сослался на индекс, которого мы не нашли, а следом назвал агентство, которого тоже не нашли ни в одном каталоге. Человек, который спрашивает про стоматологию, такую проверку провести не может. И не будет.
Партнёрство, которое подтвердилось у одной школы из трёх
В ответе про курсы английского AI трижды сослался на British Council: три школы названы партнёрами организации по IELTS, каждая своей формулировкой - «включает в список партнёров», «указывает среди партнёров», «указывает как партнёра». Это сильное утверждение: не рейтинг из карт, а ссылка на международную организацию, и родитель читает его именно так.
Мы проверили все три одинаково, точечным поиском на самом britishcouncil.uz. Подтвердилась одна школа: раздел «25 Years of British Council in Uzbekistan» описывает RIKS как партнёра шестой год подряд и единственный Gold-tier центр в стране. У второй нашлось только её собственное заявление на собственном сайте - это не независимое подтверждение. У третьей не нашлось ничего, хотя искали тем же способом, которым нашли первую. Имена двух школ мы не называем сознательно - ниже будет видно, почему.
Формулирую аккуратно: это не доказательство, что партнёрства нет, а только то, что подтвердить его через прямой источник мы не смогли. Но для родителя, который выбирает школу по словам «партнёр British Council», разница между «подтверждено» и «не подтверждено» и есть всё содержание выбора.
Цифры, которые разошлись, и урок, который мы получили сами
Обычное расхождение выглядит безобидно: AI называет 4.9 при 118 отзывах, мы находим 5.0 при 46. Так устроены карты, спорить не о чем. Но часть расхождений другого порядка. По Boboy в ответе стоит 2 694 отзыва - мы нашли около 245-259 во всех доступных нам источниках. По Carbox в ответе 5.0 при 653 оценках, причём со ссылкой на Яндекс Карты, - мы на Яндекс Картах нашли 4.3 при 137 отзывах. Плюс два названия, которых мы не нашли в том виде, в каком они прозвучали, - агентство недвижимости и B2B-агентство.
Но один сюжет стоит рассказать до конца, потому что он объясняет природу таких расхождений лучше всего. В ответе сказано: в каталоге Yellow Pages числится 96 маркетинговых агентств. Первая проверка редакции этого не подтвердила. Мы открыли английскую версию рубрики «Marketing - Services» по Ташкенту и увидели 109 компаний, потом рубрику «Рекламные агентства» - и увидели там 170. Ни одно не совпадало, строка ушла в расхождения.
Потом я открыл русскую рубрику «Маркетинговые агентства» по Ташкенту - ту самую, про которую и говорил AI. Там стоит: «Найдено организаций 96». Ровно то, что было сказано в ответе. Мы проверяли соседние рубрики и другую языковую версию, то есть не тот слой данных, - и уверенно записали в ошибку модели свою собственную.
AI может ошибиться. Но и человек, который проверяет AI, ошибается - если проверяет не тот слой данных.
Отсюда два следствия, и они держат весь остальной текст. Первое: строка Yellow Pages переезжает из расхождений в совпадения, и все цифры выше уже посчитаны с этой поправкой. Единственная правка в итог, которую внесла наша ошибка, оказалась в пользу AI, а не в нашу. Второе, важнее: я называю компанию там, где расхождение касается цифры, - речь о числе в ответе AI, а не о качестве компании. Но там, где под вопросом само существование названия, имён не будет. Ошибётся редакция - в первом случае пострадает наша методика, во втором чужая репутация.
Реклама компании, поданная как данные
Отдельная находка, для маркетолога важнее всех рейтингов. В ответе про ремонт квартир AI пересказывает: Ochag - «300+ сданных квартир с 2019 года, фиксированная смета, поэтапная оплата, 2-летняя гарантия»; Service Eco - «работу по смете без аванса/доплат, фото- и видеоотчёты и гарантию до 3 лет». Редакция проверила: у Service Eco эти формулировки стоят на его собственном сайте практически дословно.
Похоже, что это не данные, а тексты с посадочных страниц, которые дошли до ответа в исходном виде и встали в один ряд с рейтингом из карт и статистикой IT Park. Ни модель, ни кто-либо по дороге их не проверял. Это одновременно самая большая дыра в качестве ответа и самая полезная новость для бизнеса: ваш сайт - источник первого порядка, и написанное на нём может воспроизвестись почти буквально.
Четыре звена между вопросом и ответом
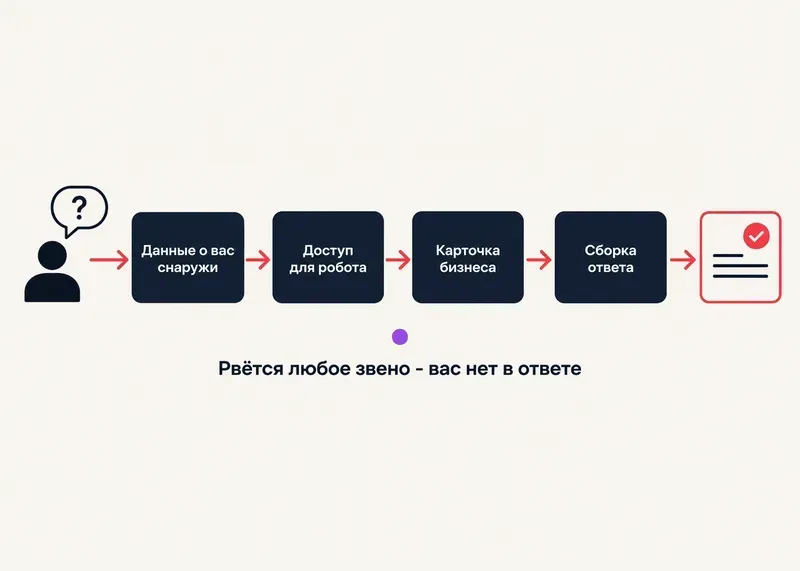
Здесь начинается третий слой - моя интерпретация всего, что мы собрали. Это рабочая схема, а не знание о том, что происходит внутри модели: алгоритма мы не видели и видеть не могли. Между вопросом человека и названием вашей компании стоят четыре звена: внешняя информационная инфраструктура, её проходимость для краулера, карточка вашего бизнеса внутри этой инфраструктуры и сборка ответа по сценарию. Рвётся любое звено - вас в ответе нет, и не потому, что вы плохой, а потому, что собирать нечего.
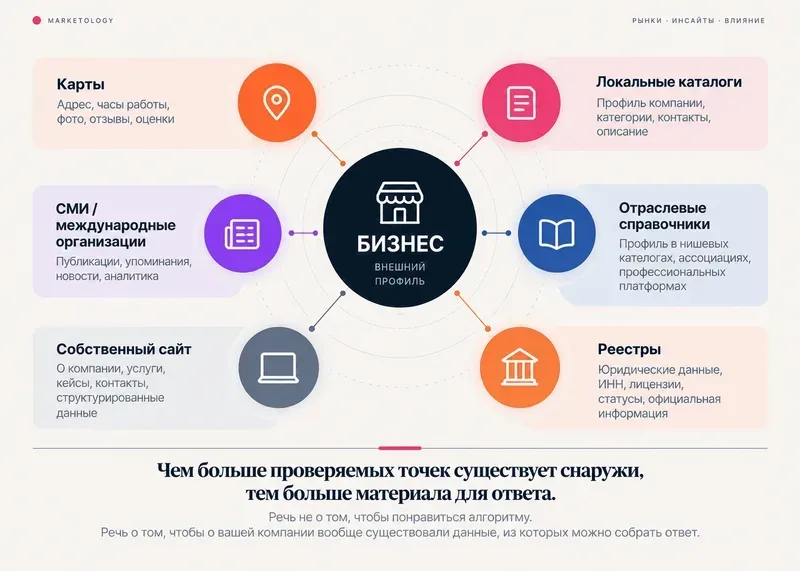
Звено первое - сама инфраструктура. Сложив десять ответов и отдельно проверив площадки руками, мы увидели семь слоёв, из которых состоит внешнее описание узбекского бизнеса: карты с рейтингами и отзывами, локальные каталоги общего профиля, отраслевые справочники, официальные реестры и институты, международные организации, сайты самих компаний и СМИ. Ещё раз оговорюсь: это не карта источников ответа - её у нас нет. Это карта того, что существует снаружи, и составлена она из двух разных вещей: из источников, которые AI назвал сам в шести ответах из десяти, и из площадок, robots.txt которых мы прочитали построчно - больше тридцати узбекских и девять международных.
Звено второе - проходимость. Слой может существовать и при этом не существовать для машины. Google Карты формально открыты, но страница карточки без JavaScript отдаёт пустой заголовок. Документы на orginfo.uz лежат в PDF, выведенных из индексации ради экономии трафика. Единый государственный регистр предприятий закрыт логином. Добавление компании в несколько каталогов переехало в Telegram-ботов, то есть наружу не отдаётся вообще. Instagram и Facebook закрыты общим запретом для всех краулеров, включая поисковый бот ChatGPT.
Звено третье - карточка. Единственное место, где бизнес управляет содержанием: название, рубрика, адрес, часы, телефон, сайт, специализация, а где есть - рейтинг и счётчик отзывов. В эксперименте AI выдавал именно этот набор полей, почти буквально. Звено четвёртое - сборка: ответ пришёл не списком, а раскладкой по сценариям, «если хочется мяса без экспериментов», «если нужен кузовной ремонт», «под IELTS». Моя гипотеза здесь простая: в сценарий попадает конкретика, а «полный спектр услуг» не попадает никуда, потому что его некуда положить.
Сайта и аккаунта в Instagram недостаточно. О компании должны существовать внешние проверяемые данные, из которых можно собрать описание.
И это не наблюдение из одного эксперимента, а рамка, по которой мы в этой рубрике будем разбирать всё остальное: проверяемость снаружи - условие того, что вы вообще попадаете в ответ. Дальше - два разреза этой цепочки, которые меня удивили больше всего.
Закрывают не того бота
Разница, которой почти никто не знает, а стоит она дорого. В документации OpenAI боты разведены по назначению. GPTBot - «used to crawl content that may be used in training our generative AI foundation models», то есть обучение моделей. OAI-SearchBot - «used to surface websites in search results in ChatGPT's search features», то есть именно тот, кто формирует ответ, который видит пользователь. Практическое следствие: закрытый GPTBot не делает сайт невидимым в ответах ChatGPT, невидимым делает закрытый OAI-SearchBot или общий Disallow: /.
Во всей узбекской выборке мы нашли ровно два сайта, которые вообще ограничивают AI-ботов: glotr.uz закрыл GPTBot, CCBot и ClaudeBot, prom.uz закрыл claudebot. Оба оставили поисковый бот ChatGPT открытым - для их клиентов это удачная конфигурация, но принята она явно не по этой логике. Общий вывод контринтуитивный: узбекский слой открыт, а не закрыт. Проблема не в robots.txt.
Два запертых ящика и один открытый
Первый запертый - sprav.uz. Узбекская версия справочника существует и отдаёт контент, но /uz/ и /en/ закрыты в robots.txt, во всех трёх блоках сразу. Контент написан, люди его видят, для краулера его нет. Более чистого примера разрыва между «сделали» и «сделали видимым» нам не встретилось.
Второй - Единый государственный регистр предприятий и организаций. registr.stat.uz редиректит на авторизацию через sso.egov.uz: главный реестр юридических лиц страны закрыт логином. Регистрация в нём обязательна по закону и не даёт ровно ничего для видимости. Рядом - orginfo.uz, где карточки организаций открыты, а документы выведены из индексации: решение рациональное, но документальный слой о бизнесе для машины перестаёт существовать.
Открытый ящик - IT Park. Весь его robots.txt состоит из двух строк: User-agent: * и пустой Disallow:. Реестр резидентов лежит обычной HTML-таблицей с юридическими названиями, ИНН и адресами - не файлом на скачивание, не за логином, не в JavaScript. И именно IT Park дал самое точное совпадение во всём эксперименте: семь компаний-экспортёров, названных AI, совпали с публикацией IT Park полностью, до последнего названия, а рядом совпали три его цифры. Открытый структурированный реестр - и максимальная точность ответа. Из этого я и вывожу всю схему выше.
Что с этим делать, по типам источников
Ни одного пункта вида «оптимизируйте контент». Дальше - где именно заводится запись и что в ней должно быть.
Карты. 2GIS заводится бесплатно через 2gis.uz/addOrg, Яндекс Карты - через Яндекс Бизнес, Узбекистан поддерживается и в Google Business Profile. Приоритет я бы ставил в таком порядке: 2GIS и Яндекс отдают карточку текстом, Google - в JavaScript. Откройте свою карточку и убедитесь, что рейтинг и счётчик отзывов видны текстом. И проверьте, нет ли двух карточек на одну компанию: дубли разбавляют отзывы.
Локальные каталоги. Golden Pages - единственный из проверенных, где карточка отдаёт schema.org-разметку LocalBusiness и FAQPage, то есть машиночитаемую структуру, а не просто текст. Yellow Pages - тот каталог, чью рубрику AI процитировал в эксперименте: попадание в рубрику и есть попадание в это число. У Magg.uz самый открытый robots.txt из всех. Top.uz с крупнейшим заявленным охватом принимает компании только через Telegram-бота.
Отраслевые справочники. Медицина - Clinics.uz и med24.uz, и обязательно узбекская версия карточки: clinics.uz/uzb/ работает и не закрыта. Мастера, ремонт, авто - ustabor.uz с практически пустым robots и всеми тремя языками. Образование - kursy.uz. Если специализированного справочника в отрасли нет, а таких отраслей много, опорными остаются карты и собственный сайт.
Реестры и институты. Для IT-компании - реестр резидентов IT Park. Для агентства - реестр Маркетинговой ассоциации по 25 направлениям. Для туроператора - реестр на uzbekistan.travel. Самые надёжные источники из проверенных: структурированные, открытые, институциональные.
Собственный сайт. Раз он попадает в ответ без верификации, на нём должны быть проверяемые факты, а не только обещания: год основания, адрес, часы, специализация, состав услуг, условия гарантии, диапазон цен. Не «полный спектр услуг», а «кузовной ремонт», «имплантация», «подготовка к IELTS», «фиксированная смета». Ответ собирается по сценариям, а в сценарий попадает конкретика.
Что бесполезно, и это лучше знать заранее. Instagram как единственное присутствие компании. Обязательная регистрация в ЕГРПО - как инструмент видимости. Узбекская карточка на sprav.uz. И публикация в СМИ, если вы рассчитываете именно на такой ответ: из статьи известно, что компания существует, но не известны адрес, часы и специализация.
Чего я не обещаю. Алгоритма отбора мы не знаем: добивочные вопросы в этом прогоне не задавались. Поэтому «попадёте в топ AI-выдачи» вы от меня не услышите. Всё перечисленное - гигиена данных о компании. Она не гарантирует попадания в ответ, но без неё попадать нечему.
Что это значит для бизнеса в Узбекистане
В прошлом гайде, про рассылки и согласия к 1 ноября, вывод был такой: собирайте собственные first-party данные, чтобы не зависеть от чужих правил. Этот материал - про обратную сторону той же задачи. Внутренние данные нужны, чтобы работать с клиентом, которого вы уже знаете. Внешние - чтобы вас нашёл тот, кто вас ещё не знает. И вторую половину почти никто не ведёт как работу: карточки заводят один раз и забывают.
Дальше честно про приоритеты, и это вывод из эксперимента, а не прогноз. Там, где в отрасли есть живой справочник и карты с отзывами - медицина, стоматология, ремонт, автосервис, образование, общепит, - AI уже называет компании поимённо, с адресами и специализацией. В этих категориях работа с карточками стоит денег уже сейчас. Там, где отрасль устроена вокруг объявлений, а не вокруг компаний, AI называет площадки: недвижимость - самый чистый пример, и отдельному агентству придётся строить узнаваемость в другом месте. А в B2B и в отраслях без справочника опорным источником остаётся собственный сайт - единственный слой, которым бизнес управляет полностью.
Речь не о том, чтобы понравиться алгоритму. Речь о том, чтобы о вашей компании вообще существовали данные, из которых можно собрать ответ.
И ещё одно, чего в исследовании нет, - скажу прямо, потому что это огромная часть рынка. Как тот же ответ выглядит на узбекском языке, мы не знаем. Узбекский массив будем собирать отдельно, по тому же протоколу, задавая вопросы заново по смыслу, а не переводом. Любые рассуждения о разнице между русским и узбекским ответом до этого - выдумка, и от меня вы их не получите.
Проверить сегодня: одна метка в аналитике
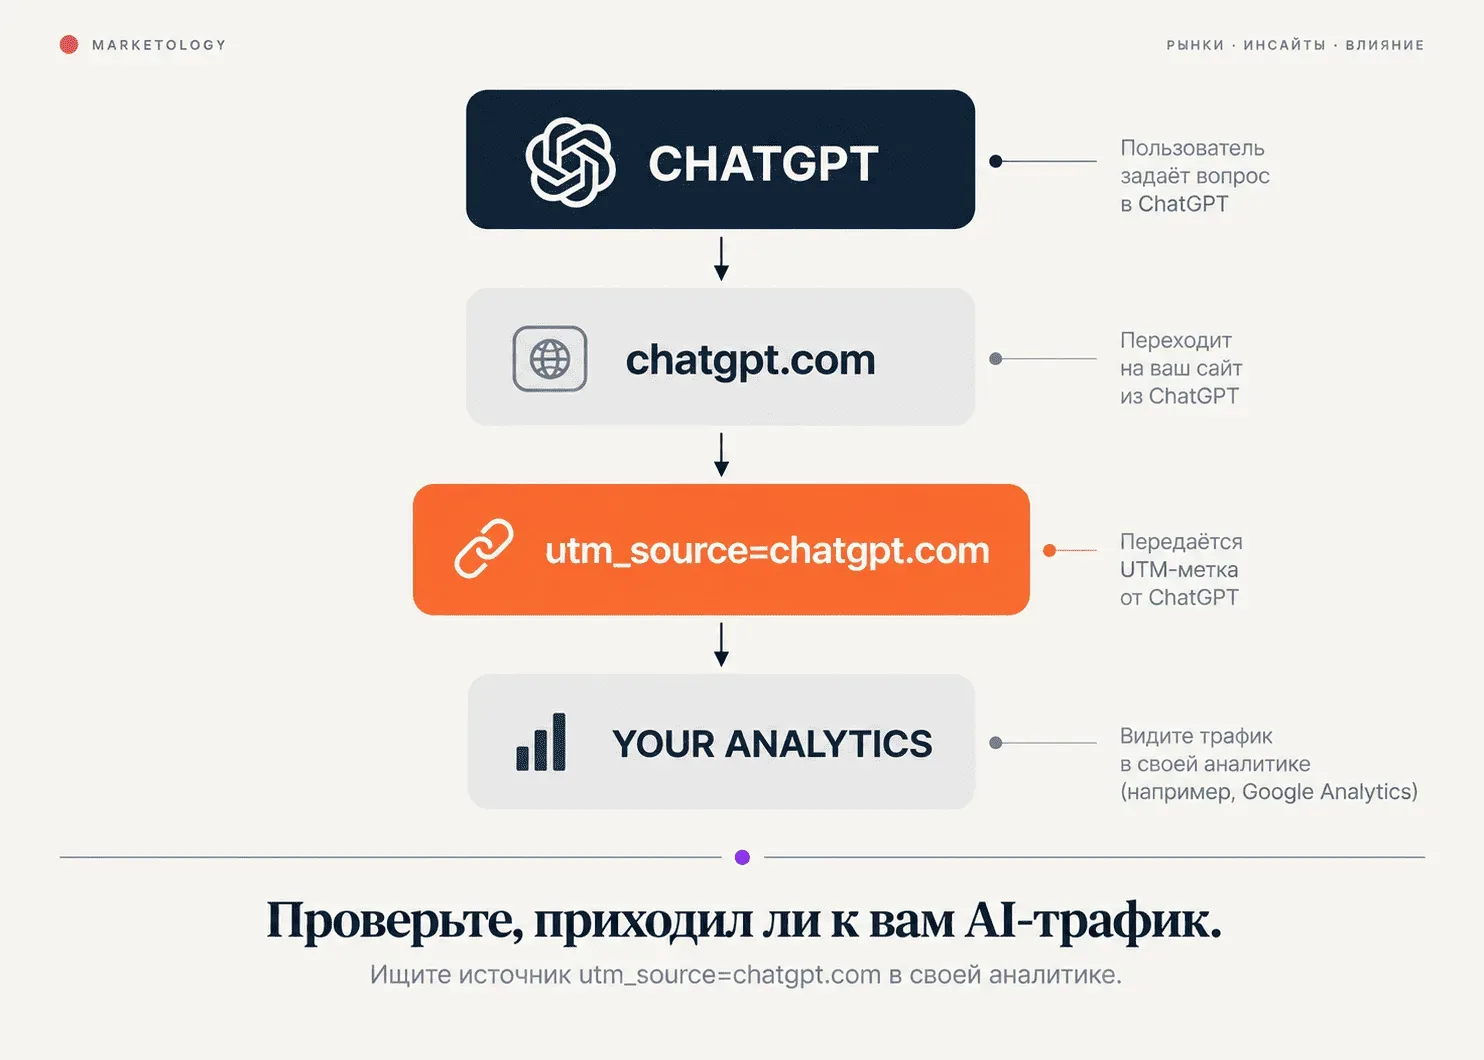
Последняя находка - самая практичная, и у неё два уровня. Механизм подтверждён первоисточником: OpenAI пишет в справке для издателей, что ChatGPT автоматически добавляет параметр utm_source=chatgpt.com к реферальным ссылкам из результатов поиска. Это заявление самой компании о своём продукте, а не наблюдение на выборке.
Наша выборка тут скромнее, чем хотелось бы, и я скажу как есть. Кликабельные ссылки появились всего в одном ответе из десяти - про недвижимость. Зато там размечены все три:
https://www.olx.uz/nedvizhimost/kvartiry/tashkent/?utm_source=chatgpt.com
https://uybor.uz/ru?utm_source=chatgpt.com
https://realt24.uz/ru/tashkent/?utm_source=chatgpt.com
Практический смысл от этого не меняется: любой бизнес с сайтом и подключённой аналитикой может сегодня открыть отчёт по источникам сессий, отфильтровать chatgpt.com и увидеть, приходили ли к нему люди из AI. Без дополнительных инструментов и без бюджета. С двумя оговорками. Метка передаётся не всегда: часть пользователей ChatGPT не передаёт referrer, и такие переходы попадают в аналитику как прямые заходы. И нередко она приходит без utm_medium, поэтому фильтры по каналам её не поймают - искать нужно по источнику.
Если таких переходов нет вообще - это не приговор, канал здесь молодой. Но это повод открыть и посмотреть, а не рассуждать. Я начал с того, что решил не рассуждать, а спросить, и половина узнанного оказалась не про AI, а про то, в каком виде наш рынок описан сам для себя. Картотека об узбекском бизнесе лежит открытой, она довольно большая и почти никем не ведётся. Для качества ответов это плохая новость. Для тех, кто возьмётся первым, - хорошая.